Arrays de Câmeras na Placa: Como FPGA/MPSoC Roda Inferência de IA em Tempo Real na Borda
Quando quatro câmeras numa linha todas devolvem a um servidor central para detecção, a banda não acompanha e a latência não comprime. O caminho melhor é fazer captura, pré-processamento e inferência na própria placa, devolvendo apenas resultados de detecção e um preview comprimido. Este artigo divide a arquitetura de IA embarcada na borda em papéis PS/PL, com o orçamento de banda e o caminho de deploy do modelo.
1. Por Que Levar a Inferência de IA Para a Placa
A abordagem centralizada legada em linhas multicâmera: cada câmera alimenta um switch, os streams brutos voltam a um servidor central, e uma GPU do servidor roda detecção em tudo. Com poucas câmeras funciona, mas com mais canais dois problemas aparecem: a banda bruta não comprimida é enorme, e a inferência centralizada adiciona latência inevitável de ida e volta na rede e de enfileiramento.
Primeiro a conta da banda bruta: um único stream bruto 1080p30, YUV422 (2 bytes por pixel) = 1920×1080×2×30 ≈ <span class=”hl”>124 MB/s ≈ 995 Mb/s</span>; quatro canais empilham cerca de 4 Gb/s de fluxo não comprimido, antes do overhead de decodificação, enfileiramento e codificação no servidor. Nesta escala, o custo do link e a latência fim a fim de uma arquitetura centralizada são difíceis de derrubar.
O esquema embarcado inverte isto: a placa faz pré-processamento e inferência localmente, e só envia resultados estruturados (bounding box, classe, confiança, alguns KB por frame) mais um preview comprimido; os pixels brutos nunca saem da placa.
2. Arquitetura de IA Embarcada: O Que Cada um de PS e PL Lida
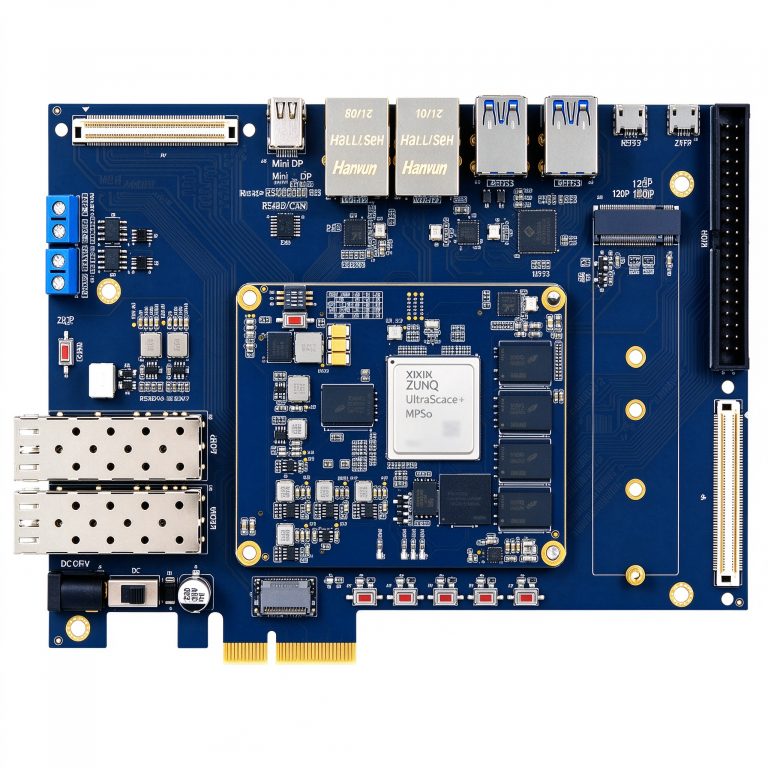
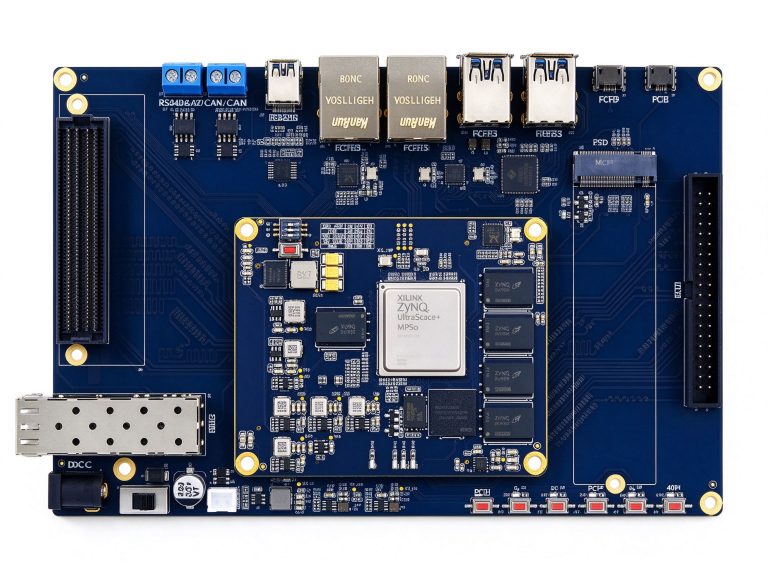
O Zynq UltraScale+ MPSoC coloca um aplicador quad-core A53 (PS) e lógica programável (PL) em um único chip, casando “escalonamento mais sistema” com “caminhos de dados paralelos.”
1. PL: Captura e Pipeline de Pré-processamento
Sinais de câmera (MIPI CSI, USB ou GigE) entram no PL, onde o paralelismo de hardware roda primeiro denoising, scaling, conversão de espaço de cor e normalização de formato. Estas operações são naturalmente por pixel e paralelas; um pipeline PL as faz bem mais rápido que uma CPU serial e deixa o A53 livre.
2. PL: Inferência Paralela em Modelos Quantizados
Convolução, pooling e ativação rodam no PL como um array paralelo de slices DSP: os pesos ficam em Block RAM/UltraRAM on-chip ou na DDR4 do lado PL, e os feature maps de entrada fluem pelo array de multiply-accumulate. Após quantização INT8, o tamanho do modelo e o tráfego de memória caem abruptamente. O PL não roda OS; seu pipeline determinístico mantém uma batida fixa por frame.
3. PS: Escalonamento, Linux e Reporte de Resultados
O PS quad-core A53 roda Linux para escalonamento de tarefas, comunicação com host e empacotamento de resultados; o encoder VCU embutido simultaneamente comprime um frame de preview para H.264/H.265 e o envia pela rede apenas quando alguém precisa visualizar.
3. Orçamento de Banda: Por Que o Fluxo Multicâmera Bruto Não Pode Voltar
| Estágio do link | 1080p30 único | Quatro canais | Observação |
|---|---|---|---|
| Bruto não comprimido (YUV422) | ~995 Mb/s | ~4,0 Gb/s | Abordagem legada de retorno total ao servidor |
| Resultado estruturado pós-pré-processamento | alguns KB/frame | alguns KB/frame | box + classe + confiança |
| Preview comprimido (H.264) | 2–4 Mb/s | 8–16 Mb/s | Enviado só quando visualizado |
O processamento embarcado corta a banda de saída de Gb/s para Mb/s ou até Kb/s; o servidor central recebe apenas resultados e não reserva mais decodificação e inferência por câmera. Esta fronteira “pixels brutos ficam na placa, só resultados saem” é a vantagem central da borda sobre um esquema centralizado.
4. Deploy do Modelo e Seleção de Placa
1. Quantize e Podem Primeiro
Quantize o modelo para INT8 na placa, pode e corte pesos para encolher o volume; depois divida os pipelines de camada pelo armazenamento on-chip e pela capacidade DSP, para que a tabela de pesos inteira não precise entrar no chip de uma vez. Um fluxo estilo Vitis-AI compila, quantiza e deploya o modelo em unidades de aceleração PL, enquanto o PS Linux ainda hospeda a aplicação.
2. Escolha uma Placa por Contagem de Canais e Computação
<div class=”case”>
<h3>Papéis das Placas de Visão na Borda: Protótipo Entrada / Computação Multicanal / Paralelo FPGA Puro</h3>
<ul>
<li><strong>Protótipo edge entrada (DUUZ4EV, RFQ)</strong>: XCZU4EV, 192K logic cells, 728 DSP, VCU embutido, PS 4GB + PL 4GB DDR4; para protótipos de IA na borda de uma a duas câmeras e validação rápida PYNQ.</li>
<li><strong>Alta computação multicanal (DUUZ5EV, RFQ)</strong>: XCZU5EV, 256K logic cells, 1.248 DSP, 16 pares GTH, expansão FMC-LPC; a plataforma para mais canais e modelos mais pesados.</li>
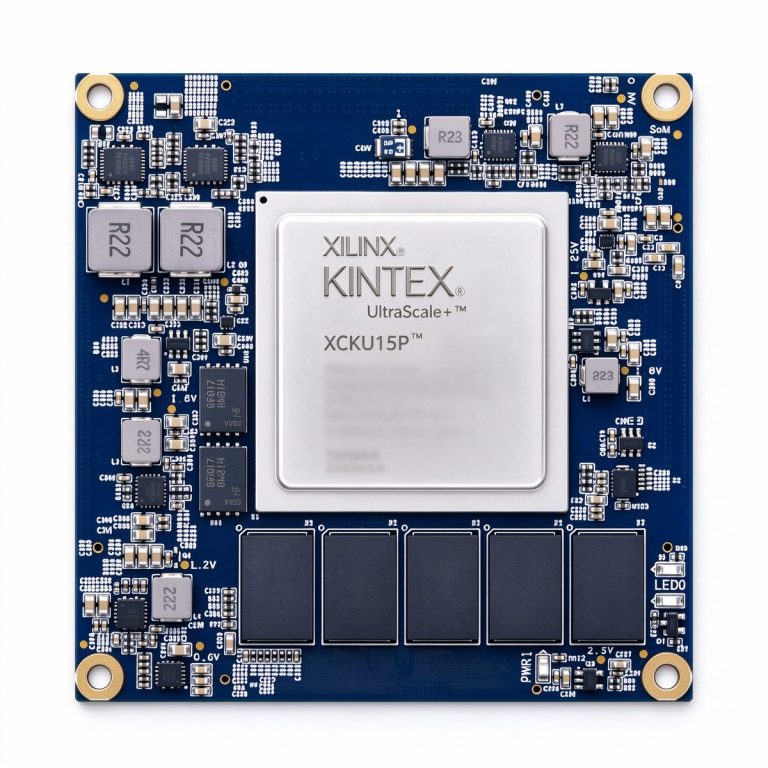
<li><strong>Expansão paralela FPGA puro (XCKU15P, ¥15.999)</strong>: placa núcleo Kintex UltraScale+ para processamento paralelo de streams multicâmera e agregação de alta velocidade onde um sistema PS não é necessário.</li>
</ul>
</div>
Inferência de IA na borda não é encolher a GPU do servidor; significa fatiar toda a cadeia “captura–pré-processamento–inferência–reporte” na placa: o PL carrega o processamento paralelo de pixels e a convolução quantizada, o PS carrega o escalonamento e a comunicação, e o VCU comprime o preview ao longo do caminho. Os pixels brutos ficam na placa e só os resultados saem — tanto a banda quanto a latência folgam.