Planejamento de Banda PCIe: Quanta Banda Útil Você Realmente Ganha de Gen3 x4 a x16?
A conta de banda do PCIe é bem mais complexa do que o número na ficha técnica — banda bruta, overhead de codificação, overhead de protocolo, eficiência de DMA e o gargalo da DDR cada um come um pedaço daqueles “16 GB/s”. Este artigo percorre Gen3 x4/x8/x16, chegando até o casamento entre DDR e DMA, e dá um método reutilizável para estimar a banda útil.
1. Três Camadas de Banda: Bruta, Codificada, Útil
Quando você vê “PCIe Gen3 x16” numa ficha, sua intuição diz 16 GB/s. Esse número na verdade é a taxa de bit bruta, não a banda que você pode usar no seu sistema. Duas camadas de perda ficam no meio:
| Camada | Cálculo Gen3 x16 | Resultado | Significado |
|---|---|---|---|
| ① Taxa de bit bruta | 16 lanes × 8,0 GT/s | 128 Gb/s | Taxa bruta de símbolo no link |
| ② Banda pós-codificação | 128 × 128/130 (Gen3 usa 128b/130b) | ≈ 126 Gb/s ≈ 15,75 GB/s | Taxa de payload após overhead de codificação |
| ③ Banda útil real | 15,75 × eficiência de transferência (80%–90%) | ≈ 12,6 – 14,2 GB/s | Banda realmente utilizável após headers TLP, descritores DMA e interrupções |
O Gen3 roda 8,0 GT/s por lane com apenas 1,5% de overhead de codificação 128b/130b — é por isso que o Gen3 é bem mais eficiente que o Gen2 (que carrega 20% de overhead 8b/10b). Comparação entre larguras:
| Largura PCIe | Taxa de bit bruta | Banda pós-codificação | Banda útil típica (DMA de bloco grande) |
|---|---|---|---|
| Gen3 x4 | 32 Gb/s | ≈ 3,94 GB/s | ≈ 3,2 – 3,5 GB/s |
| Gen3 x8 | 64 Gb/s | ≈ 7,88 GB/s | ≈ 6,3 – 7,1 GB/s |
| Gen3 x16 | 128 Gb/s | ≈ 15,75 GB/s | ≈ 12,6 – 14,2 GB/s |
| Gen2 x8 (referência) | 40 Gb/s | ≈ 4,0 GB/s (8b/10b) | ≈ 3,2 – 3,6 GB/s |
2. Quanto Custa o Protocolo: TLP, Payload, Leitura vs Escrita
Banda pós-codificação não é banda útil. Todo PCIe Transaction Layer Packet (TLP) carrega um header de 12–20 bytes; quanto maior o payload, menor a parcela do header, e maior a eficiência.
O Tamanho do Payload Define Diretamente a Eficiência
| Tamanho de payload | Parcela do header TLP | Eficiência de transferência | Cenário típico |
|---|---|---|---|
| 4 KB (máx) | ≈ 0,4% | ≈ 90%+ | Aquisição DMA contínua de bloco grande, streams de vídeo |
| 512 B | ≈ 3% | ≈ 85–88% | Retorno geral de dados |
| 64 B | ≈ 25% | ≈ 55–65% | Leituras/escritas de registradores, controle de pacotes pequenos |
Leituras são Mais Lentas que Escritas: O Custo Oculto do Completion
Escritas PCIe são fire-and-forget; o emissor não espera confirmação. Leituras PCIe precisam esperar um Completion TLP voltar — uma viagem de ida e volta que dobra a latência e custa banda. Medido:
- Escritas sequenciais de bloco grande: 88–92% da banda pós-codificação
- Leituras sequenciais de bloco grande: tipicamente apenas 80–85% (fila de Completion, overhead)
- Leitura/escrita mistas: a troca de direção causa stalls no link, derrubando a eficiência em mais 5–10%
No planejamento de engenharia, use a estimativa conservadora “banda útil = pós-codificação × 80%”, não o número ideal de 90%+, para deixar folga.
3. A DDR é o Teto Real
Um link PCIe rápido não significa que o sistema roda em velocidade total — os dados que entram e saem do FPGA precisam cruzar a DDR, e a banda da DDR costuma ser a primeira parede que você bate.
Como Calcular a Banda da DDR
Banda da DDR = largura do barramento de dados × taxa de dados / 8. Para as placas comuns da Duyuan:
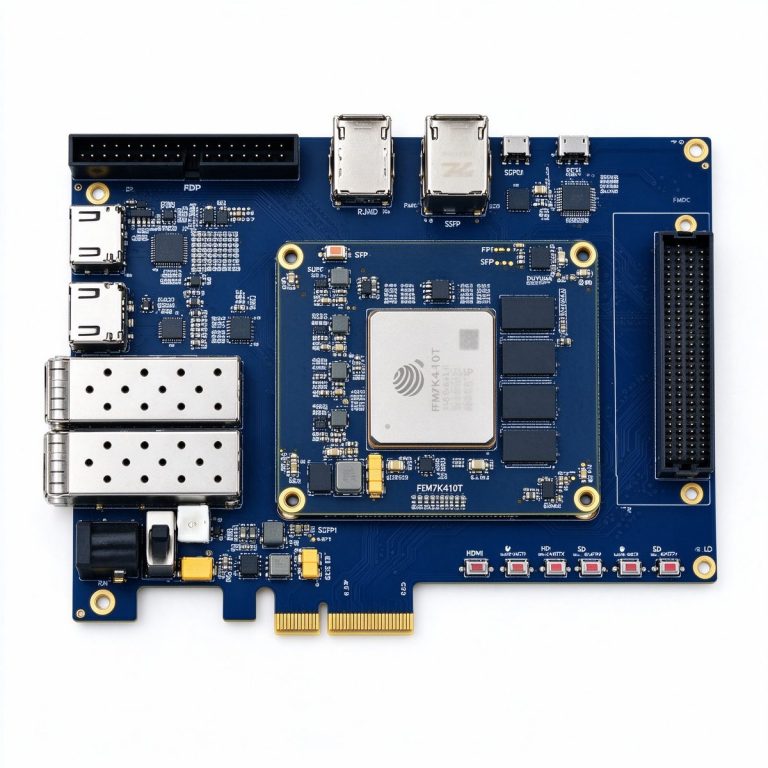
- DUK7410T: 4 GB DDR3, barramento de 64 bits, 1866 Mbps → 64 × 1866 / 8 ≈ 14,9 GB/s
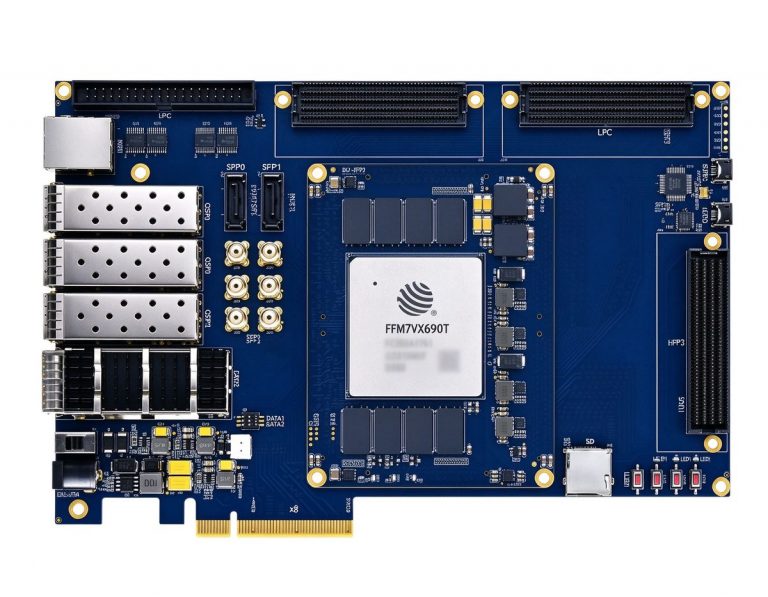
- DUF7690T: 4 GB DDR3, 64 bits, 1866 Mbps → ≈ 14,9 GB/s
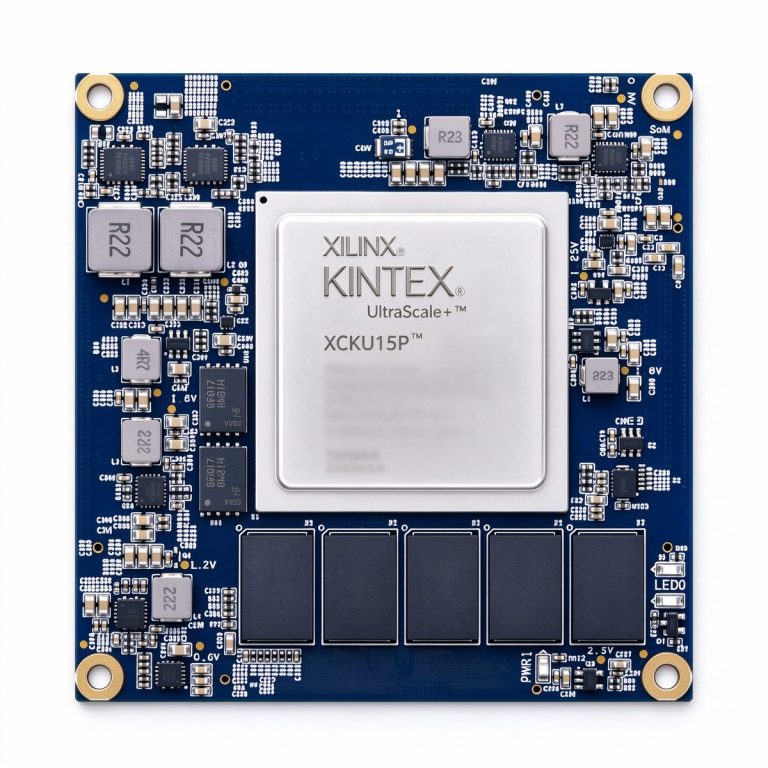
- DUKU15P: 8 GB DDR4 ECC, barramento de 64 bits (+8 bits ECC) → a 2400 MT/s ≈ 19,2 GB/s
O Fluxo de Dados é Bidirecional: Leitura + Escrita Dobram a Carga
Considere um cenário de aquisição de alta velocidade: os dados do ADC são processados pelo FPGA e escritos de volta ao host via PCIe. Esse caminho de dados cruza a DDR duas vezes:
- FPGA recebe dados → escrita DDR (frame buffer)
- FPGA termina o processamento → leitura DDR (busca para transmissão)
- Carga total da DDR = banda de escrita + banda de leitura
Se a banda útil do PCIe x8 Gen3 é 7 GB/s, a DDR precisa escrever 7 GB/s e ler 7 GB/s simultaneamente = 14 GB/s — chegando perto do limite físico da DDR3 de 14,9 GB/s, sobrando quase nada para o algoritmo do FPGA. É por isso que x8 Gen3 com DDR3 é a “combinação dourada”, enquanto x16 exige DDR4.
| Placa | Spec PCIe | Banda pós-codificação | Config DDR | Banda DDR | Veredito |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4,0 GB/s | 4 GB DDR3 64 bits | ≈ 14,9 GB/s | PCIe é o gargalo, DDR tem folga |
| DUF7690T | Gen3 x8 | ≈ 7,88 GB/s | 4 GB DDR3 64 bits | ≈ 14,9 GB/s | ~7,5 GB/s cada via, no equilíbrio |
| DUKU15P | Gen3 x16 | ≈ 15,75 GB/s | 8 GB DDR4 64 bits | ≈ 19,2 GB/s | DDR chega ao limite com carga PCIe total |
4. Estimativa em Três Passos: Quanta Banda Seu Projeto Precisa?
Metodologia · 01: Estimativa de Banda PCIe em Três Passos
Passo 1: Calcule a demanda líquida. Some as taxas de dados brutas de todas as fontes — o volume mínimo que precisa ser movimentado.
Passo 2: Aplique um fator de redundância. Multiplique por 1,2–1,5 para overhead, rajadas e duplex.
Passo 3: Retrocalcule a largura PCIe. Escolha um spec em que a banda pós-codificação ≥ demanda redundante, depois verifique se a DDR acompanha.
Validado contra três cenários comuns:
| Cenário | Taxa bruta de dados | Demanda pós-redundância | PCIe recomendado | Por quê |
|---|---|---|---|---|
| Aquisição alta velocidade (2ch × 250 MSPS × 14-bit) | ≈ 875 MB/s | ≈ 1,1 – 1,3 GB/s | Gen3 x4 (3,94 GB/s) | Folga ampla, DDR sem stress |
| Captura e processamento de vídeo 4K60 (10-bit 4:2:2) | ≈ 1,5 GB/s | ≈ 1,8 – 2,3 GB/s | Gen3 x8 (7,88 GB/s) | Espaço para vídeo multicanal ou costura |
| Retorno em bloco de feature maps de inferência IA / vídeo 8K | ≈ 10 – 12 GB/s | ≈ 12 – 18 GB/s | Gen3 x16 (15,75 GB/s) | Exige DDR4, senão a DDR bate na parede primeiro |
Regra prática: ao escolher a largura PCIe, retrocalcule da demanda líquida × 2, e deixe um fator de folga inteiro de dois. Você pode fazer upgrade de banda, mas não pode fazer upgrade de largura sem redesenhar a placa.
5. Escolha entre as Três Plataformas PCIe da Duyuan
DUK7410T (¥9,999) — Aquisição e Processamento Sensível a Custo
Fudan Micro JFM7K410T, PCIe Gen2 x8 hard IP, ~4 GB/s pós-codificação. Combine com mezaninos FMC HPC para aquisição ADC de alta velocidade, ou processamento de vídeo HDMI 4K — comece aqui quando a banda PCIe não é o gargalo.
DUF7690T (¥24,999) — Aquisição Mainstream e Processamento Composto
Fudan Micro JFM7VX690T, PCIe Gen3 x8 hard IP, ~7,88 GB/s pós-codificação. Com 4 GB DDR3 a ~7,5 GB/s cada via, casa com a banda total do x8. Plataforma mainstream para aquisição multicanal, processamento de radar e costura de vídeo.
DUKU15P (¥15,999) — Retorno de Dados de Gama Alta e Interconexão 100G
AMD Kintex UltraScale+ XCKU15P, PCIe Gen3 x16 hard IP, 15,75 GB/s pós-codificação, acompanhado de 8 GB DDR4 ECC. Integra 56 transceptores de alta velocidade (24× GTY 28G + 32× GTH 16G) e 4× 100G Ethernet hard IP — escolha flagship para retorno PCIe de banda larga mais rede de alta velocidade.
A banda PCIe nunca é só “velocidade de interface” — é a placa mais curta entre “interface × memória × DMA”. Planeje primeiro a folga da DDR, depois fale em quão rápido o PCIe pode rodar.
>
— Equipe de Engenharia Duyuan