VU13P em Trading Quantitativo: Uma Plataforma de Hardware de Baixa Latência, da Decodificação de Dados de Mercado à Execução de Ordens
A essência do trading quantitativo é completar o ciclo de informação “chegada de dados de mercado → cálculo de sinal → transmissão de ordem” no menor tempo possível. Este artigo usa a plataforma AMD Virtex UltraScale+ XCVU13P (VU13P) como fio condutor, explicando por que ela serve ao trading quantitativo e como implantá-la em uma cadeia de trading de baixa latência entregável.
A essência do trading quantitativo é completar o ciclo de informação “chegada de dados de mercado — cálculo de sinal — transmissão de ordem” no menor tempo possível. Na escala de microssegundos de um matching engine de bolsa, a latência em si é custo: chegar um microssegundo atrasado significa slippage de preço, oportunidades perdidas ou a falha de uma estratégia inteira. Na última década, as principais firmas de trading proprietário migraram progressivamente as partes mais críticas da cadeia do software em CPU para hardware FPGA — decodificação de dados de mercado na placa, order book na placa, decisão de estratégia na placa e geração de ordens na placa. Este artigo usa a plataforma AMD Virtex UltraScale+ XCVU13P (VU13P) como fio condutor, discutindo por que ela serve ao trading quantitativo e como implantá-la em uma cadeia de trading de baixa latência entregável.
1. A Estrutura de Latência do Trading Quantitativo: Por Que a Resposta é FPGA
Uma cadeia típica de trading automatizado — desde um pacote de dados de mercado chegando à NIC até uma ordem saindo da NIC — passa sequencialmente pela pilha de rede, parse de dados de mercado, manutenção do order book, cálculo de sinal, checagem de risco e codificação de ordem. Em uma pilha de software, interrupções de kernel, processamento da pilha de protocolo, escalonamento de threads e cache misses introduzem jitter incontrolável; a implementação em hardware transforma esses estágios em uma profundidade de pipeline fixa com latência determinística, sem interrupções e sem escalonamento. Latência típica de ponta a ponta tick-to-trade para diferentes abordagens:
Tabela: comparação de latência tick-to-trade de ponta a ponta (compilada de fontes públicas)
| Implementação | Latência típica de ponta a ponta |
|---|---|
| Software comum + pilha de rede do kernel | 10–100 µs |
| Software com kernel-bypass (DPDK / Onload + core pinning) | 1–5 µs |
| Cadeia FPGA completa (parse → estratégia → ordem) | 300 ns – 1 µs |
| Gatilho pré-armado em FPGA (pattern match e envio) | 30–100 ns |
| Switch de Layer-1 (fan-out / replicação pura) | aprox. 5 ns |
Três propriedades do FPGA determinam esta diferença de ordem de grandeza: paralelismo — múltiplos feeds de mercado e instâncias de estratégia rodam simultaneamente em hardware sem contenção; determinismo — sem interrupções ou escalonamento, a latência de processamento de cada pacote é fixa, o que importa tanto para risco quanto para auditoria; proximidade — portas ópticas conectam diretamente ao FPGA, contornando o PCIe e a pilha de protocolo, decodificando pacotes à medida que chegam. Dados públicos do setor confirmam: certas soluções anunciam latência tick-to-trade round-trip abaixo de 100 ns; o design de referência da AMD com parceiros para a CME atinge latência de gatilho pré-armado na casa dos 25 ns; um artigo de 2025 da revista Computer Applications and Software descrevendo um sistema de aceleração de dados de mercado ultrarrarraso baseado em OpenCL atingiu 678 ns de processamento mínimo de dados de mercado em uma Alveo U50 com throughput de 38,4 Gbit/s, aproximadamente 12× de ganho de desempenho sobre a abordagem em software.
2. Visão Geral da Plataforma VU13P
A VU13P pertence à família AMD Virtex UltraScale+ e é um dispositivo representativo no ponto de equilíbrio “escala de lógica × interface de alta velocidade”. Segundo a documentação oficial de produto da AMD, suas especificações-chave são:
Tabela: especificações-chave do XCVU13P (fonte: página oficial de produto Virtex UltraScale+ da AMD)
| Métrica | Especificação XCVU13P |
|---|---|
| System Logic Cells | 3.780K (aprox. 3,78 milhões de logic cells) |
| DSP Slices | 12.288 |
| Transceptores de alta velocidade GTY | 128 pares (até 32,75 Gb/s por par) |
| User I/O | 832 |
| Interfaces de alta velocidade integradas | PCIe Gen3 x16, 100G Ethernet MAC, 150G Interlaken (blocos duros no die) |
| Computação DSP | até aprox. 38 TOP/s |
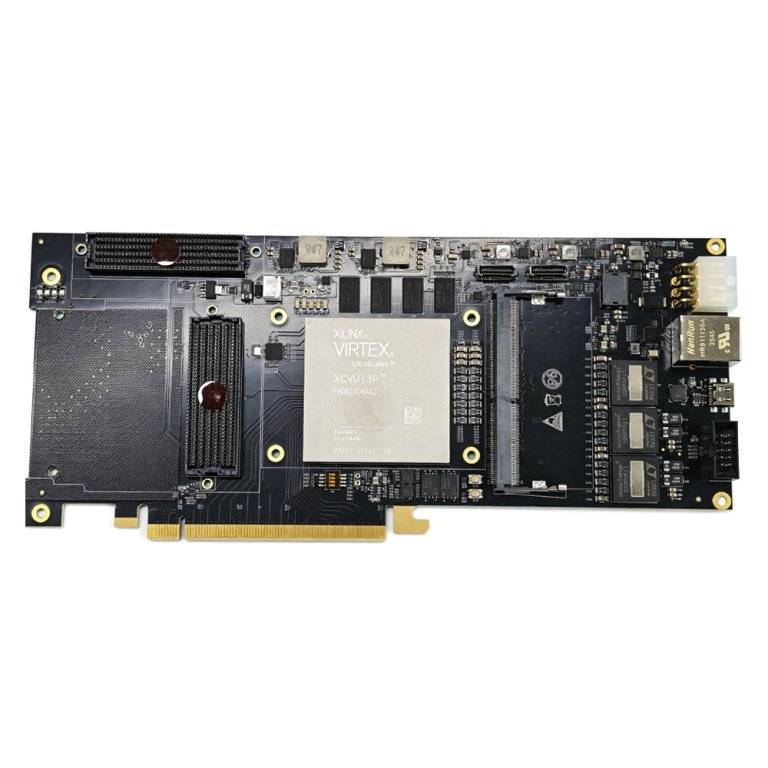
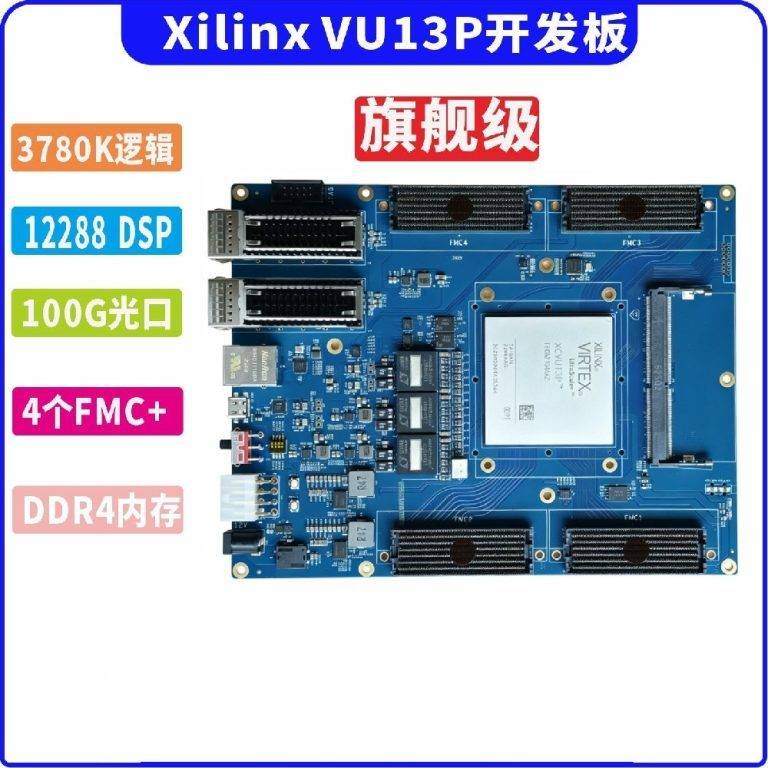
No nível de placa, a plataforma de desenvolvimento ultra-alta gama VU13P da Duyuan Electronics oferece gold fingers PCIe Gen3 x16, múltiplas portas ópticas 100G (QSFP28), expansão FMC+ de alta velocidade, expansão DDR4 SODIMM e faixa de temperatura industrial de −40°C a 85°C. Para trading quantitativo, esta placa fornece naturalmente três coisas: conectar diretamente múltiplos feeds de bolsa ao FPGA (portas ópticas + GTY), alocar volume substancial de lógica de estratégia dentro do FPGA (3,78 milhões de logic cells + 12.288 DSP), e interconexão host bidirecional de alta banda (PCIe Gen3 x16).
3. Quatro Aplicações Centrais da VU13P na Cadeia de Trading Quantitativo
3.1 Decodificação e Pré-processamento de Dados de Mercado (Feed Handler)
Protocolos de dados de mercado de bolsa (NASDAQ ITCH, CME MDP3, formato FAST comum em bolsas europeias, etc.) chegam a taxas de pacotes extremamente altas; o parse em software exige decodificação, validação e reconstrução de estrutura por pacote, sendo o gargalo mais antigo e típico da cadeia. Na VU13P, o parse de dados de mercado é implementado como um pipeline de hardware: os pacotes são decodificados como streams de bytes ao entrarem pela porta óptica, com extração de campo, validação e remontagem de protocolo concluídas dentro de estágios fixos de pipeline, enquanto múltiplos feeds (múltiplas bolsas, linhas primário-backup A/B) são processados em paralelo. Os 128 transceptores GTY e as múltiplas portas ópticas 100G oferecem ampla capacidade simultânea de conexão; para bolsas que publicam por linhas duplas primário-backup (como as linhas A/B da CME), a arbitragem de linha e o failover sem costura podem ser implementados em hardware para evitar lacunas de dados de mercado causadas por jitter de linha única. As estruturas padrão de dados de mercado decodificadas são escritas diretamente em armazenamento on-chip para os módulos de estratégia downstream, nunca passando pela CPU do host.
3.2 Order Book em Hardware e Execução Paralela de Estratégias
Manter um order book consultável exige operações frequentes de inserção, exclusão, modificação e ordenação; implementações em software dependem de acesso à memória e locks, enquanto implementações em hardware mapeiam os níveis de preço diretamente em estruturas Block RAM on-chip, com busca de preço e decisões de casamento concluídas em ciclos fixos. Sobre esta base, os 3,78 milhões de logic cells da VU13P permitem que múltiplas instâncias de estratégia rodem em paralelo em um único dispositivo: diferentes instrumentos, diferentes mercados e até diferentes lógicas de estratégia (market making, arbitragem cross-market, arbitragem de latência, regressão estatística) podem ocupar partições lógicas independentes, compartilhando o mesmo stream de dados de mercado decodificado sem interferência. Para estratégias de gatilho sensíveis à latência, pode-se usar uma abordagem de “ordem pré-armada”: templates de ordem são escritos no buffer de transmissão com antecedência, e quando o hardware detecta a condição definida (ruptura de preço, mudança da razão de volume) dispara a transmissão diretamente, contornando o caminho de decisão em software, comprimindo a latência para dezenas de nanossegundos.
3.3 Risco Pré-Negociação
Bolsas e estruturas de compliance impõem requisitos de risco cada vez mais rígidos ao trading algorítmico: banda de preço, limite de quantidade por ordem, posição diária acumulada, frequência de ordens e outras checagens precisam ser concluídas antes do envio de uma ordem. O problema da checagem de risco em software é que ela fica no caminho crítico e adiciona latência; a checagem de risco em FPGA coloca a lógica de verificação em paralelo ao lado do caminho da ordem — toda ordem passa por vários estágios de checagem de risco no pipeline de hardware, e é imediatamente codificada e enviada na aprovação, ou bloqueada em nanossegundos na rejeição. As regras de risco são configuradas via registradores/tabelas de memória e podem ser atualizadas a quente durante o pregão, atendendo a requisitos de compliance sem sacrificar baixa latência no caminho principal.
3.4 Backtesting, Simulação e Aceleração de P&D
Além da cadeia de produção, os grandes recursos de lógica da VU13P também suportam P&D de estratégias: carregue engines de replay de dados de mercado e simulação na placa de desenvolvimento para backtesting em nível de hardware contra dados históricos, rodando múltiplas estratégias em paralelo — significativamente mais rápido que simulação em software; use Vivado/Vitis HLS para mapear rapidamente algoritmos C/C++ em implementações de hardware, encurtando o ciclo de iteração “ideia de estratégia → hardware testável”. Uma organização de engenharia típica é “FPGA roda o caminho de produção, CPU roda monitoramento e análise”: o processamento de ordens e dados de mercado de produção acontece inteiramente na placa, enquanto o host lê status via PCIe Gen3 x16 e envia para baixo parâmetros de estratégia e regras de risco, balanceando desempenho e operações.
4. Arquitetura de Sistema Típica de Ponta a Ponta
Uma plataforma de trading quantitativo baseada em VU13P tem uma topologia típica como segue:
- Ingresso de dados de mercado: feeds de bolsa entram no FPGA diretamente por portas ópticas 100G (QSFP28), com 128 pares GTY carregando múltiplas linhas;
- Parse em hardware: módulos Feed Handler decodificam, validam e arbitram linhas A/B em um pipeline segundo o protocolo (ITCH/FAST/MDP3, etc.);
- Order book e sinais: BRAM on-chip mantém order books de múltiplos instrumentos, partições de estratégia computam sinais em paralelo, e ordens são geradas quando condições de gatilho são atendidas;
- Risco e codificação: ordens passam por checagens de risco pré-negociação e são codificadas em mensagens de protocolo de bolsa antes de entrar no buffer de transmissão;
- Interconexão com o host: confirmações de ordem, relatórios de execução e monitoramento de status são enviados ao host via PCIe Gen3 x16; parâmetros de estratégia e regras de risco são enviados para baixo a partir do host;
- Interfaces de expansão: FMC+ é usado para conectar NICs customizadas / placas filhas aceleradoras; OCULINK para interconexão de alta velocidade entre placas, para escala multi-placa.
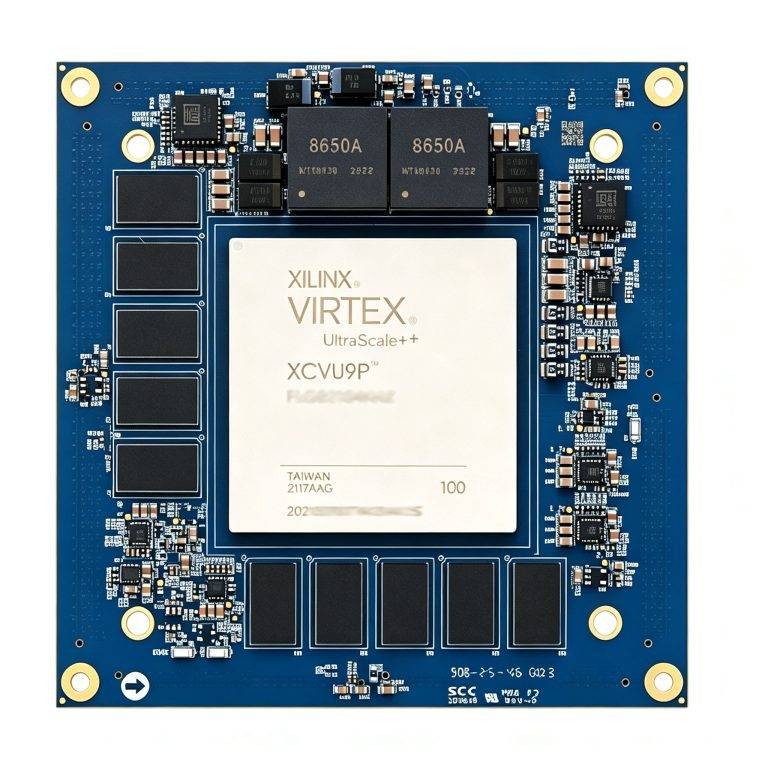
Na forma de implantação, a placa de desenvolvimento VU13P pode servir diretamente como placa aceleradora PCIe dentro de um servidor; para cenários sensíveis a espaço em rack e potência, um formato de core board de menor consumo pode ser customizado com base nesta plataforma.
5. Vantagens de Engenharia da VU13P Sobre Outras Abordagens
Tabela: perspectiva de comparação de plataformas de hardware para trading quantitativo
| Dimensão | Vantagem relativa da VU13P (FPGA) |
|---|---|
| Latência de ponta a ponta | cadeia completa 300ns–1µs, pré-trigger 30–100ns; abordagens em software tipicamente 1–100µs |
| Determinismo de latência | profundidade de pipeline fixa, sem jitter de interrupção/escalonamento, bom para risco e auditoria |
| Capacidade paralela | 3.780K logic cells + 12.288 DSP, múltiplas estratégias/instrumentos simultaneamente |
| Banda de interface | 128×GTY, múltiplas portas ópticas 100G, PCIe Gen3 x16, ingresso direto multi-bolsa |
| Flexibilidade | reconfigurável: mudanças de estratégia são config/reload, sem troca de placa; ciclo de desenvolvimento muito mais curto que ASIC |
| Limite de desenvolvimento | menor que ASIC; Vitis HLS/OpenCL mapeia de C/C++, caminhos críticos otimizados adicionalmente em RTL |
Comparado com CPU: a VU13P está uma ordem de grandeza à frente em latência e determinismo; comparado com GPU: GPUs se destacam em throughput de lote, mas o pipeline e o escalonamento introduzem jitter de latência que as tornam inadequadas para caminhos críticos de nanossegundos, enquanto a latência determinística da VU13P é um encaixe natural; comparado com ASIC: ASIC tem o melhor desempenho, mas custo one-time proibitivo e ciclo de desenvolvimento longo, adequado apenas para algoritmos totalmente congelados, enquanto a VU13P retém flexibilidade para evolução da estratégia. É por isso que as firmas de trading proprietário adotam amplamente “FPGA no caminho crítico, CPU/GPU para pesquisa e computação offline” como divisão padrão de trabalho.
6. Essenciais de Desenvolvimento e Implantação
- Divisão da toolchain: caminhos críticos (parse de protocolo, codificação de ordem) usam RTL para garantir latência; lógica de estratégia pode ser implementada rapidamente com Vitis HLS / OpenCL, validando comportamento em simulação de software primeiro, depois sintetizando para hardware;
- Interfaces modulares: Feed Handler, Order Book, Strategy, Risk e Gateway usam uniformemente interfaces de dados AXI-Stream, facilitando substituição, reuso e colaboração em equipe;
- Clock e sincronização: em implantações multi-placa/multi-site, introduza PTP/1PPS e uma árvore de clock de baixo jitter para unificar a base de tempo, garantindo que relatórios de execução e timestamps de dados de mercado estejam alinhados;
- Comece por uma placa padrão: primeiro conclua o parse de dados de mercado e a validação de estratégia na placa de desenvolvimento VU13P, faça a cadeia de latência funcionar de ponta a ponta, depois customize o formato da placa (contagem de interfaces, potência, estrutura mecânica) conforme as necessidades do projeto;
- Monitoramento e regressão: mantenha contadores de estatística e pontos de observação ILA na lógica de hardware, monitore a latência de cada estágio de pipeline durante o pregão, e qualquer degradação pode ser localizada rapidamente.
7. Limitações e Recomendações de Seleção
FPGA não é a resposta para todo cenário quantitativo. Se uma estratégia faz rebalanceamento em horizontes de minuto ou hora, ou depende de features de aprendizado de máquina em larga escala com iteração frequente de modelos complexos, as vantagens de custo e flexibilidade da pilha de software em CPU/GPU são mais óbvias; se a equipe não tem capacidade de desenvolvimento em hardware, o ciclo de avaliação, debug e manutenção de um projeto FPGA precisa ser totalmente previsto. Quando a baixa latência em hardware está confirmada como requisito, a seleção do dispositivo pode ser estratificada por necessidade de recursos:
- VU9P: 2.586K logic cells, 6.840 DSP, com 2×200G + 4×100G portas ópticas, 32GB DDR4 ECC, PCIe x16 — adequado a cenários com grande ingresso de dados de mercado e ênfase em armazenamento/banda;
- VU13P: 3.780K logic cells, 12.288 DSP, 128×GTY — adequado a multiestratégia paralela, lógica de estratégia complexa e cenários que precisam de mais recursos on-chip; a plataforma principal abrangente para esta classe de aplicações;
- VU13F: também 12.288 DSP, com 4×FMC+ oferecendo I/O expansível extenso e interfaces de placas filhas — adequado a integração de nível de sistema que exige NICs customizadas, front-ends de RF e outros hardwares externos.
Nota: os números de latência neste artigo são faixas típicas de fontes públicas; os valores reais dependem de protocolos, taxas de pacotes, implementação da estratégia e roteamento da placa. A seleção e a aceitação devem ser baseadas em medição no local.
8. Conclusão
A hardwareização do trading quantitativo é uma tendência certa há anos: desde o early offload de NIC, até mover o parse de dados de mercado e a cadeia inteira de ordens para o FPGA, até hoje onde um único dispositivo classe VU13P carrega simultaneamente dados de múltiplos mercados, múltiplas estratégias e controle de risco. O valor da VU13P está em colocar “escala” e “velocidade” no mesmo dispositivo — lógica e DSP suficientes para combinações complexas de estratégia rodarem em paralelo em hardware, e GTY e portas ópticas 100G suficientes para que o ingresso multi-bolsa não seja mais um gargalo. A Duyuan Electronics oferece placas de desenvolvimento padrão VU13P/VU9P, core boards customizados, pacotes de IP de decodificação de dados de mercado e cadeia de baixa latência, e suporte técnico de ponta a ponta, ajudando equipes a avançar rapidamente da validação em placa de avaliação para uma plataforma de hardware de trading quantitativo implantável.
Referências
- AMD, página de produto FPGA Virtex UltraScale+ (especificações XCVU13P): https://www.amd.com/en/products/adaptive-socs-and-fpgas/fpga/virtex-ultrascale-plus.html
- AMD/Xilinx com LDA, solução de referência CME Tick-to-Trade de 25 nanossegundos: https://www.xilinx.com/publications/solution-briefs/partner/xilinx-lda-amd-tick-to-trade-solution-brief.pdf
- libfpga, FPGAs in high-frequency trading: the anatomy of a nanosecond (comparação de latência tick-to-trade): https://libfpga.com/blog/fpgas-for-hft
- semidesignjobs, FPGAs in High-Frequency Trading: A Technical Deep Dive: https://www.semidesignjobs.com/blog/fpga-hft-technical-deep-dive
- Enyx, nxFramework (plataforma tick-to-trade sub-100ns): https://www.enyx.com/nxframework/
- Computer Applications and Software 2025, Design and implementation of an ultra-low-latency market data acceleration system based on OpenCL: https://shcas.net/cn/article/doi/10.3969/j.issn.1000-386x.2025.03.003
- ACM, DSL Programmable Engine for High Frequency Trading Acceleration (aceleração do protocolo FAST): https://dl.acm.org/doi/pdf/10.1145/2088256.2088268
Duyuan Electronics · Prática de Aplicação | Dados de setembro de 2026; diferentes instituições usam escopos diferentes, todas as fontes anotadas.