Retorno de Fibra 10G/25G: Planejamento de Taxa de Linha GTX/GTH e Offload UDP
Quando vários ADCs de alta velocidade, feixes de radar ou streams de vídeo se encontram, o cabo de cobre chega no máximo após alguns metros e o PCIe não pode sair do chassi. O retorno correto é acionar SFP+/QSFP diretamente dos transceptores GTX/GTH do FPGA, fazer offload do MAC e da pilha IP/UDP on-chip, e enviar apenas o payload por fibra na taxa de linha. Este artigo desenvolve a taxa de linha 10G/25G, o payload UDP, o orçamento de link e a divisão interna de trabalho do FPGA.
1. Por Que Dados de Alta Velocidade Precisam de Retorno por Fibra
Dentro da placa você usa PCIe, e links curtos placa-a-placa usam cobre, mas uma vez que os nós de aquisição estão distribuídos, a distância ultrapassa alguns metros e cada canal roda vários Gb/s ou mais, o cobre e o backplane batem no teto primeiro:
1. Teto de distância: um cabo DAC a 10G geralmente suporta apenas 3–5 m, e o cobre ativo também é limitado; fibra monomodo com módulo óptico chega facilmente a 10 km, servindo arrays de aquisição distribuídos e front-ends de radar remotos.
2. Teto de banda: um único 1080p60, um IF SDR multicanal ou um IQ de radar mesclado frequentemente ultrapassa 10 Gb/s; cobre gigabit e backplanes não carregam, então você precisa de SFP+ (10G) ou QSFP28 (25G/100G).
3. Imunidade a temporização e ruído: em ambientes industriais ruidosos, a fibra fornece isolamento elétrico, imunidade a crosstalk e loops de terra, e temporização comum mais estável entre nós.
O padrão típico: uma placa de aquisição remota só faz amostragem ADC e pré-processamento, empacota os resultados e envia por uma fibra a um servidor central, que não processa canais individualmente, apenas recebe o stream agregado. Aqui a taxa de linha do link e o overhead de protocolo decidem diretamente quantos nós podem ser ligados.
2. Taxa de Linha 10G/25G e Orçamento de Payload UDP (Calcule o Payload Primeiro)
Muitos tratam uma “porta de 10 Gb/s” como banda utilizável, mas o que chega à camada de aplicação é o payload após codificação, gap entre frames e headers de protocolo. Comece de como a taxa de linha surge:
| Item | 10G (SFP+) | 25G (QSFP28) | Observação |
|---|---|---|---|
| Taxa Ethernet nominal | 10,0 Gb/s | 25,0 Gb/s | Taxa MAC efetiva |
| Taxa de linha codificada 64b/66b | 10 × 66/64 = <span class=”hl”>10,3125 Gb/s</span> | 25 × 66/64 = <span class=”hl”>25,78125 Gb/s</span> | Taxa de bit real no fio |
| Overhead de frame MTU 1500 | Preamble/SFD 8B + gap 12B + Eth 14B + IP 20B + UDP 8B | Igual | ~62B não-payload por frame |
| Razão de payload UDP | 1500/(1500+62) = <span class=”hl”>96,03%</span> | ≈96,03% | Exclui retransmissão da camada de aplicação |
| Taxa de payload UDP (MTU1500) | 10 × 96,03% ≈ <span class=”hl”>9,60 Gb/s</span> | 25 × 96,03% ≈ <span class=”hl”>24,0 Gb/s</span> | O que a camada de aplicação realmente recebe |
| Razão Jumbo Frame (9000B) | 9000/9062 = 99,32% | 99,32% | Eleva payload para ~9,93 / ~24,8 Gb/s |
Conclusão chave: sobre UDP MTU1500, uma porta 10G entrega apenas cerca de 9,6 Gb/s à aplicação, não 10 Gb/s. Dimensione os nós pelo payload: se cada nó envia 2 Gb/s de dados efetivos, um link 10G aguenta cerca de 4–5 nós (9,6 / 2, com folga), não os 5 cheios. Para aproximar da taxa de linha, ative Jumbo Frame para amortizar o overhead fixo por frame.
BER e Orçamento de Link
Um link de fibra não está feito uma vez plugado; primeiro calcule o orçamento de potência óptica: potência de transmissão − sensibilidade do receptor = margem de link, da qual você deduz a atenuação da fibra (monomodo 1310 nm ≈ 0,35 dB/km) e a perda de emenda/conector (~0,5 dB por conector). O multimodo SR 850 nm é limitado por distância e OM3/OM4; o monomodo LR 1310 nm chega a 10 km. Um link compatível mira BER melhor que 1e-12; o 25G adiciona comumente correção de erros direta RS-FEC, corrigindo erros brutos de ~1e-5 para 1e-15, então inclua o ganho de codificação do FEC no orçamento.
3. Como o FPGA Divide o Trabalho
1. Transceptores GTX/GTH Acionam o Módulo Óptico
O GTX da série-7 chega no máximo a 10,3125 Gb/s, casando com SFP+ 10G; o GTH/GTY de UltraScale/UltraScale+ rodam acima de 16G e suportam 25G. O transceptor cuida da serialização/desserialização, codificação 8b/10b ou 64b/66b e recuperação de clock; externamente restam apenas os pares de alta velocidade e o gerenciamento I2C do módulo (leitura DDM).
2. MAC e Processamento de Frame
Acima do transceptor está o MAC Ethernet 10G/25G: delimitação de frame, checagem CRC, controle de fluxo PAUSE. O Rx descarta frames com CRC ruim e filtra por MAC de destino; o Tx encapsula frames e preenche os gaps. Esta camada é um pipeline determinístico adequado a hardware completo.
3. Motor de Offload UDP
Deixar a CPU empacotar IP/UDP por frame vira gargalo a 10G. Offload on-chip: hardware preenche IP de origem/destino, portas e checksum; o usuário só escreve o payload no buffer DMA, e o motor adiciona headers Eth/IP/UDP, calcula o checksum e fragmenta pela MTU. A CPU não empacota, só configura a tabela de endereços uma vez na inicialização — isto é offload de pilha de protocolo.
4. Estatística de Erros e Monitoramento de Link
Contadores on-chip somam erros CRC, frames descartados e correções FEC, reportados periodicamente pelo canal de gerenciamento; DDM do módulo de potência Tx, potência óptica Rx e temperatura também são coletados, alertando cedo quando a margem cai, em vez de esperar uma imagem quebrada.
4. Caso de Engenharia: Aquisição Multinó com Retorno por Fibra 10G
Um sistema de aquisição distribuído tem 4 nós remotos; cada um mescla dois canais IF SDR e um canal de vídeo para ~2,2 Gb/s efetivos de retorno; o centro agrega por uma fibra 10G, e com Jumbo Frame o payload é ~9,9 Gb/s, então 4 nós somando 8,8 Gb/s deixam folga. Todos os protocolos são com offload UDP no FPGA; o host só recebe payload.
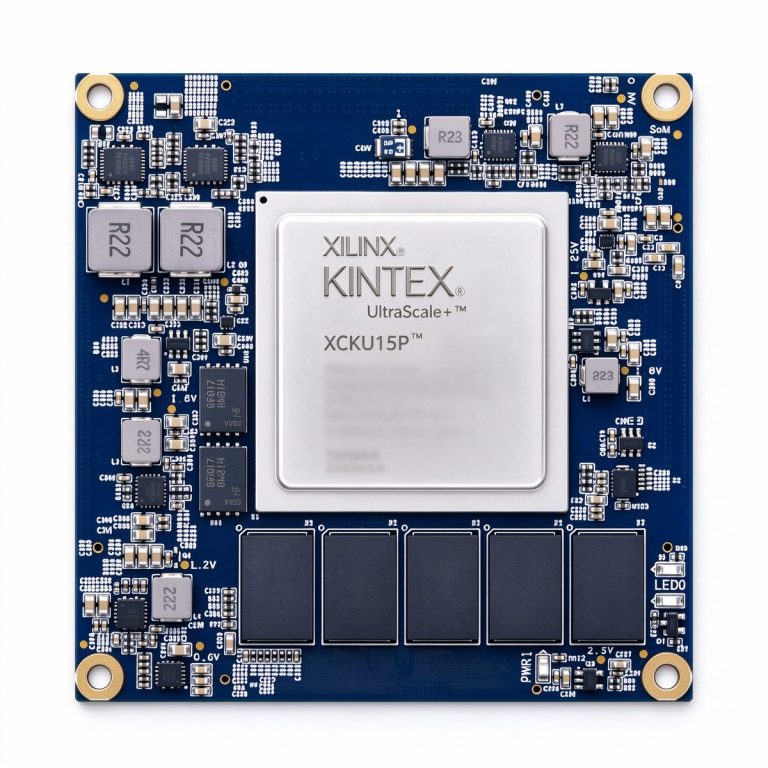
- Link de banda larga (XCKU15P / Kintex UltraScale+): folga generosa de transceptor GTY para 25G ou múltiplas lanes 10G, adequado a um nó principal de agregação que pode escalar para 25G/100G.
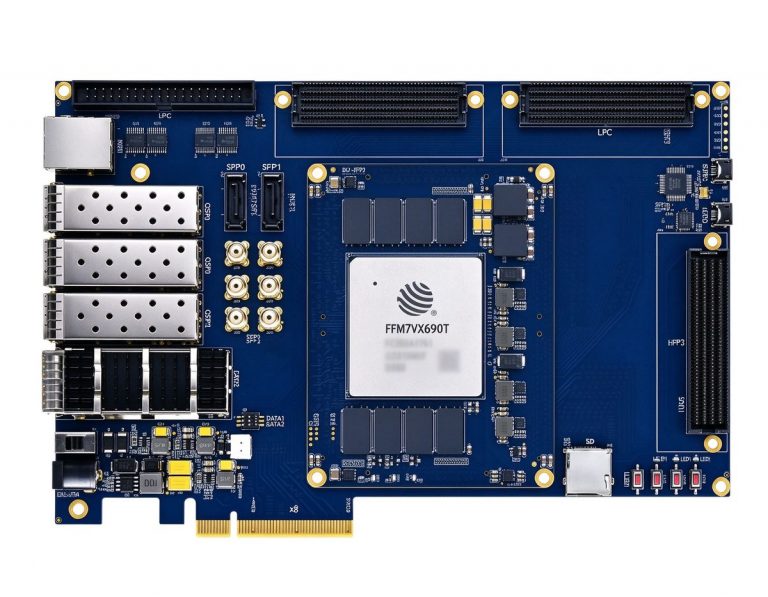
- Agregação de alta capacidade (DUF7690T / JFM7VX690T): lógica e RAM on-chip amplas para vários MACs, motores de offload UDP e filas grandes, adequado à agregação multinó central e ao forwarding na taxa de linha.
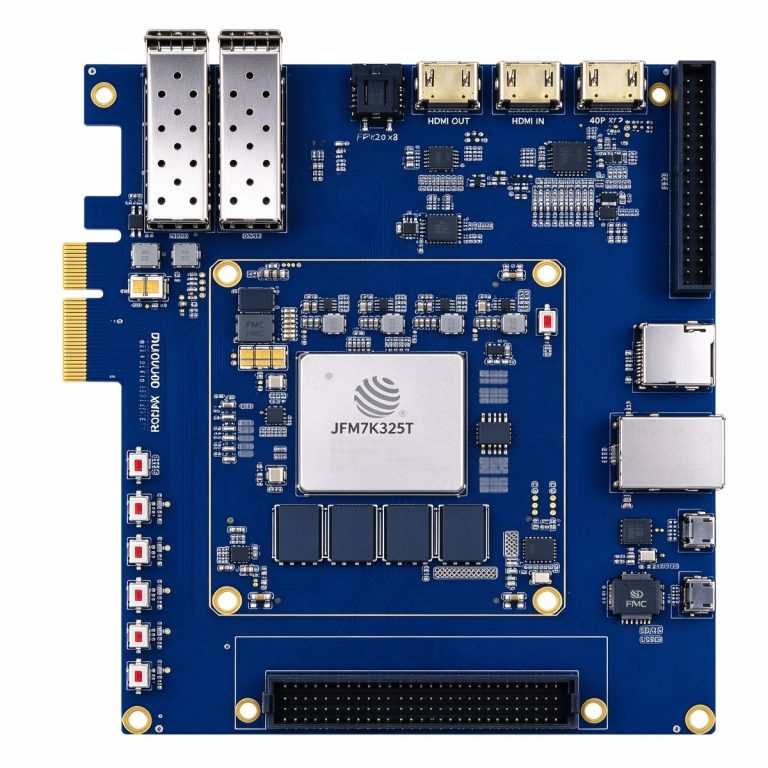
- Entrada de protótipo 10G (DUK7325T / JFM7K325T): o GTX da série-7 satura a taxa de linha 10G com custo equilibrado, adequado a protótipo 10G de nó único e produtos entrada.
O retorno de fibra é essencialmente deixar os transceptores do FPGA e a pilha de hardware terminarem “enviar na taxa de linha” em nome da CPU. Guarde dois números: sobre MTU1500, o 10G entrega ~9,6 Gb/s e o 25G ~24 Gb/s de payload. Dimensione os nós pelo payload, não pela taxa nominal, calcule o orçamento de link e a BER de antemão, e o retorno não perde velocidade em campo.