Inspeção de Visão Industrial em Tempo Real com FPGA: De Câmeras GigE à Calibração de Defeitos
Ao longo de uma linha de inspeção de defeitos, dos pixels da câmera até o sinal de rejeição, onde exatamente o FPGA é insubstituível? Este artigo faz primeiro o balanço de banda de todo o fluxo de dados, depois detalha os quatro papéis que o FPGA desempenha na linha de visão, compara os limites de tempo real entre algoritmos tradicionais e deep learning, e finalmente apresenta uma seleção de hardware implantável por meio de um caso real de estação AOI de solda em PCB.
1. Primeiro, a Conta de Banda: Fluxo de Dados em uma Linha 1080p60
O primeiro obstáculo da visão industrial não é o algoritmo, é a banda. Comece pelo caminho mais comum — uma única câmera GigE Vision 1080p, 60fps — e calcule sua taxa de dados:
| Formato de saída | Cálculo | Resultado | Aguenta em um link gigabit? |
|---|---|---|---|
| Bayer de 8 bits (mais comum) | 1920 × 1080 × 8 bit × 60 | ≈ 995 Mb/s ≈ 124 MB/s | Satura 99,5% de 1 Gbps, por pouco |
| Bayer de 12 bits (HDR / pouca luz) | 1920 × 1080 × 12 bit × 60 | ≈ 1,49 Gb/s ≈ 187 MB/s | Estoura o gigabit; precisa de 2,5G/10G ou CoaXPress |
| 4 câmeras de 8 bits | 995 Mb/s × 4 | ≈ 4 Gb/s ≈ 500 MB/s | Precisa de agregação de 4 gigabit ou uplink 10G |
Se você transmitir esses frames brutos inteiros para uma CPU ou GPU, cada canal despeja 124–187 MB por segundo; quatro canais somam 500 MB/s. No lado da CPU você ainda precisa processar o frame completo — queimando banda e computação nas duas pontas. O que a detecção de defeitos realmente precisa é apenas “onde está a anomalia, qual o tipo, quais as coordenadas” — muitas vezes algumas centenas de bytes.
A Chave: Onde os Pixels São Processados Decide o Custo de Toda a Linha
Mover frames brutos para outro lugar e processá-los é a mentalidade do “transportador”; processar os pixels no mesmo fluxo é a mentalidade do “pipeline”. A primeira adiciona um canal inteiro de banda e computação para cada câmera extra; a segunda adiciona apenas lógica de processamento.
2. Os Quatro Papéis do FPGA na Linha de Visão
Papel 1: Interface Bring-Up e Sincronismo Multicâmera
O parsing dos protocolos GigE Vision / CoaXPress, a configuração de parâmetros da câmera e o gerenciamento de trigger são feitos diretamente pela camada MAC do FPGA e pela lógica de trigger. Várias câmeras travaram no mesmo relógio de hardware, garantindo que frames de pontos de vista diferentes sejam expostos no mesmo instante — algo que o software dificilmente iguala de forma determinística.
Papel 2: Pré-processamento de Imagem (Ruído, Ganho, Interpolação Bayer)
Denoising, balanço de branco, ganho, interpolação Bayer, extração de ROI — tudo são operações por pixel. O pipeline do FPGA avança naturalmente um pixel por ciclo de clock; o pixel clock do 1080p60 fica em torno de 148,5 MHz, bem dentro da margem de temporização de dispositivos como o JFM7K410T. O mesmo trabalho por pixel na CPU é um loop de vários a dezenas de milissegundos por frame; no FPGA é uma latência fixa de algumas dezenas de ciclos.
Papel 3: Detecção de Defeito (Template, Diferença, Componentes Conexos)
Template matching, diferença entre frames, limiarização, análise de componentes conexos, processamento morfológico — tudo paralelizável, tudo empipelável. O template matching sobre uma imagem 1080p no FPGA roda em menos de 1 ms por frame, com latência independente da taxa de quadros e totalmente determinística — um requisito duro para o ciclo da linha.
Papel 4: Saída de Resultado e Coordenação de IO
O veredito aciona diretamente o atuador de rejeição, a lâmpada de alarme e os contadores estatísticos. A latência de saída das GPIOs do FPGA é de escala nanossegundo, sem desvios por sistema operacional, driver ou camada de aplicação. No instante em que um defeito aparece, o sinal de rejeição já chegou ao atuador.
3. Dois Caminhos de Algoritmo: Visão Tradicional vs Deep Learning
“É só adicionar deep learning” virou mantra em projetos de visão nos últimos anos, mas o limite de tempo real entre os dois caminhos precisa ser desenhado com clareza:
| Dimensão | Visão tradicional (template/diferença/morfologia) | Deep learning (classe CNN/YOLO) |
|---|---|---|
| Latência single-frame 1080p | <1 ms (pipeline FPGA) | 2–10 ms (GPU) ou mais (NPU genérico) |
| Pegada de recursos | Poucos LUT/DSP | DSP pesado + banda de memória externa |
| Interpretabilidade | Limiar ajustável, defeitos rastreáveis | Caixa preta, difícil localizar falsos positivos |
| Melhor cenário | Padrões fixos de defeito, linhas de ciclo rápido | Defeitos complexos, reinspeção off-line de amostras variadas |
| Implementado em FPGA | Maduro, altamente engenhado | Precisa de quantização/poda; geralmente em CPU/GPU |
A arquitetura dominante da linha em 2026 é pré-processamento em FPGA + veredito tradicional em tempo real + re-checagem deep learning off-line: o FPGA garante o veredito e a rejeição dentro do ciclo, enquanto o deep learning faz a confirmação secundária nas regiões suspeitas — cada um faz o que sabe fazer melhor.
4. Um Caso Real: Estação AOI de Solda em PCB
Caso de Engenharia · 01: Inspeção de Solda em Linha SMT — 60fps Contínuo, Taxa de Falso Alarme < 0,5%
Uma estação AOI de linha SMT precisa detectar solda fria, pontes de solda e componentes faltando, rodar continuamente a 60fps, com meta de falso alarme abaixo de 0,5% e taxa de perda de solda fria abaixo de 1%.
- Câmeras: 2 câmeras industriais GigE de 20 MP, na verdade recortadas para ROI 1080p, saída Bayer de 8 bits
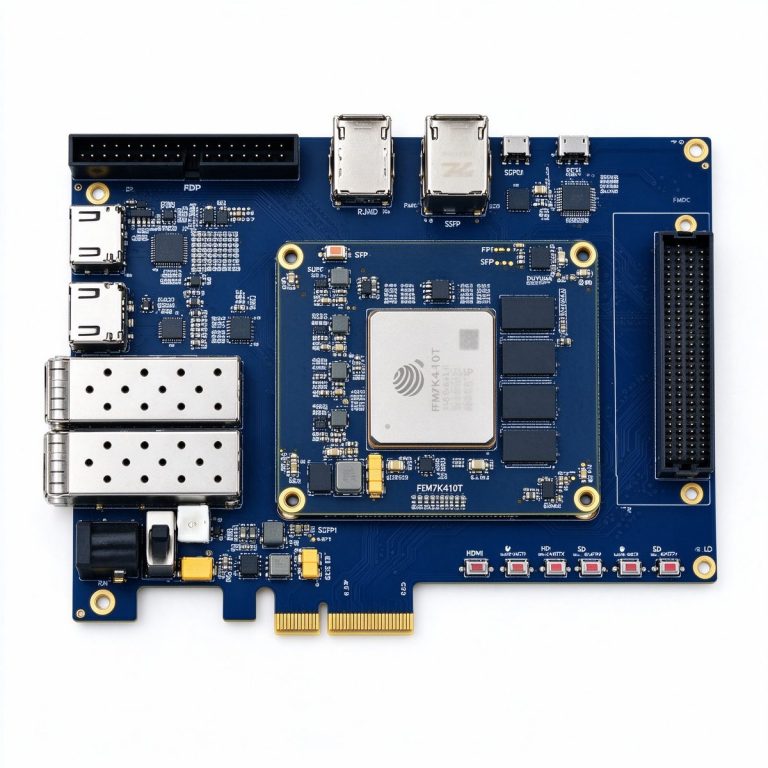
- Placa: DUK7410T (Fudan Micro JFM7K410T, 406K logic cells, FMC HPC, 4 GB DDR3)
- Fluxo de dados: 2 × 995 Mb/s ≈ 2,5 Gb/s no FPGA → frame buffer DDR → diferença por template + análise de componentes conexos → saída do veredito
Resultados medidos: processamento single-frame < 0,8 ms; latência fim a fim do trigger da câmera à saída de rejeição < 1,5 ms; taxa de falso alarme < 0,5%; taxa de detecção de solda fria > 99%.
Contra a linha de base em CPU: a latência fim a fim caiu de ~15 ms para < 1,5 ms, e a carga da CPU do host de 85% para 5% — o pipeline de software original só chegava a 30fps; trocar para FPGA dobrou a vazão.
A chave desta estação não é um algoritmo sofisticado — é que a ação de inspeção acompanha o ciclo da linha. No instante em que um frame com defeito chega, o veredito e a rejeição precisam terminar antes do próximo frame.
5. Como Escolher o Hardware: Três Placas, Três Estratégias
A seleção segue três perguntas: quantas câmeras? quão dura é a exigência de latência? qual o orçamento total da máquina? Aqui estão três plataformas comuns da Duyuan:
DUK7410T (¥9,999) — o Workhorse de Gama Média, Escolha Padrão para AOI de 1/2 Câmeras
Fudan Micro JFM7K410T, 406K logic cells, 1.540 DSPs, FMC HPC, entrada HDMI 4K, 2× SFP+. O FMC HPC liga direto em mezaninos de câmera de alta velocidade ou ADC; a entrada HDMI 4K pode servir também como loopback de display. Posicionamento de visão, detecção de defeito, protótipos de costura multicâmera — a maioria dos projetos começa aqui.
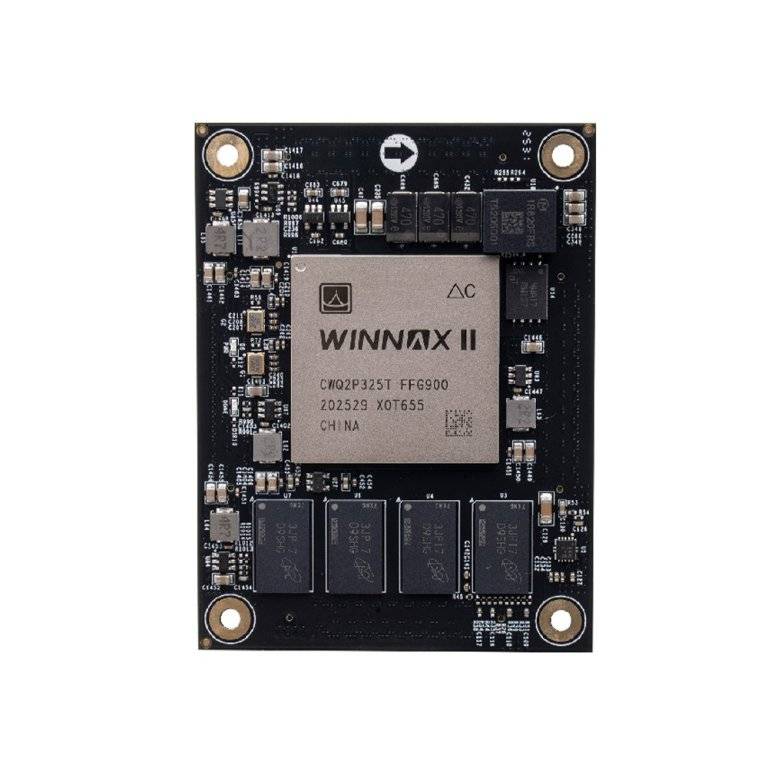
PBC7K325G (¥1,999) — Integração Embarcada com Máquina Sensível a Custo
SoM com arquitetura China Kintex-7, 326K logic, 16 transceptores GTX, 2 GB DDR3, grau industrial −40 a 85 °C. Inspeção embarcada de padrão fixo com câmera única, ou controladores combinados de visão + controle de movimento. Produtos sensíveis a custo saem daqui.
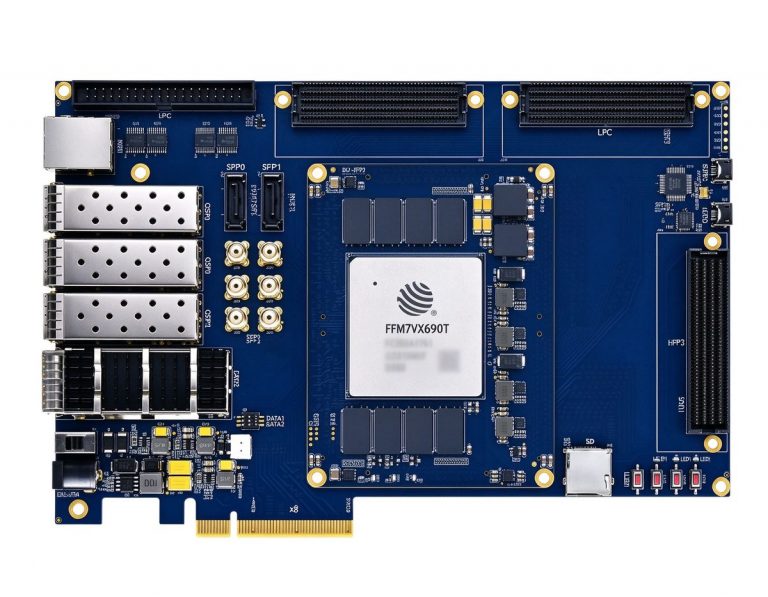
DUF7690T (¥24,999) — Arrays Multicâmera e Sistemas Compostos de Alta Performance
Fudan Micro JFM7VX690T, 693K logic cells, 3.600 DSPs, 36 pares GTH, QSFP 40G. Arrays de 8+ câmeras, costura 8K, ou sistemas compostos de visão + comunicação de fibra — quando você precisa de lógica grande e banda grande, suba para esta placa.
O primeiro princípio da visão industrial é “não fique transportando frames inteiros” — processe os pixels no ponto onde eles fluem, e os problemas de latência, banda e potência desaparecem na hora.
>
— Equipe de P&D Duyuan